



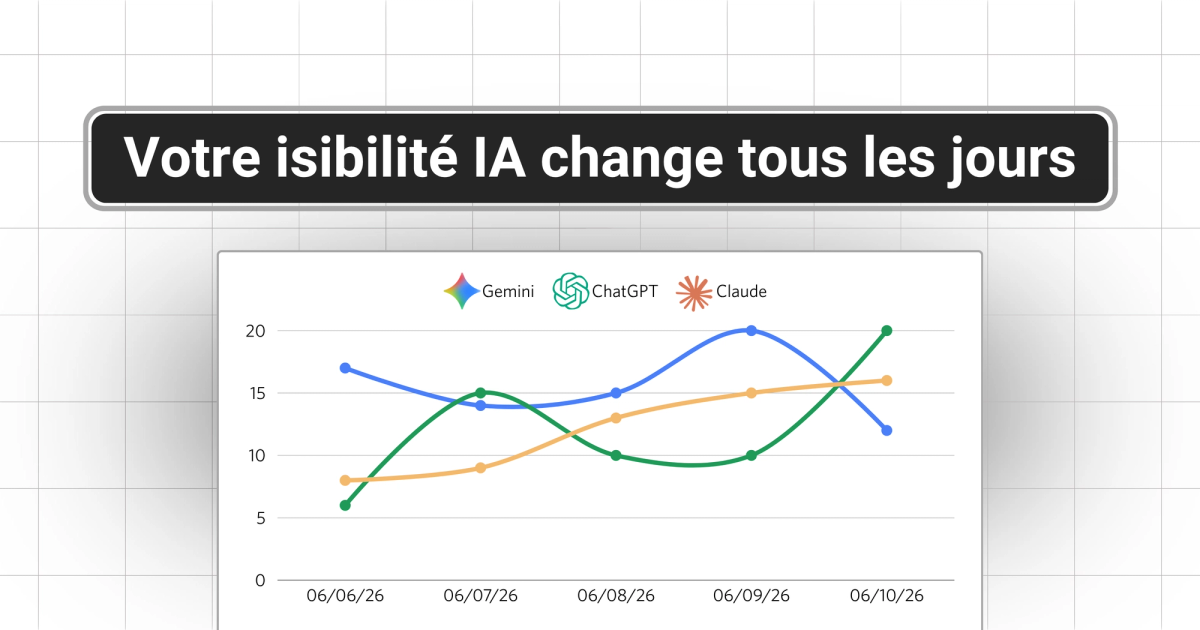
Vous avez ouvert ChatGPT, tapé le nom de votre catégorie, et votre marque était là. Bonne nouvelle. Mais si vous recommencez la même recherche dans une heure, vous obtiendrez peut-être une réponse complètement différente. Et demain, encore une autre. Une étude académique publiée en avril 2026 le documente avec des données empiriques : les LLMs sont stochastiques par nature, et mesurer votre visibilité IA une seule fois ne vous dit rien de fiable. La question n'est pas si vous apparaissez. C'est à quelle fréquence, sur combien de prompts, et avec quelle stabilité dans le temps.
Ce que stochastique veut dire concrètement
Un modèle de langage ne produit pas la même réponse à chaque fois. Il génère du texte en sélectionnant des tokens selon des probabilités, introduisant une variation à chaque génération. Deux facteurs amplifient cet effet. Le premier est la température du modèle : plus elle est haute, plus les réponses varient. Le second est le contexte de recherche : quand un LLM avec accès au web récupère des sources en temps réel, les résultats de recherche qu'il obtient changent aussi d'une requête à l'autre.
Concrètement, poser la même question à ChatGPT dix fois de suite peut produire dix réponses qui mentionnent des marques différentes, dans des ordres différents, avec des formulations différentes. Sill, qui analyse les données de visibilité LLM de centaines de marques, a mesuré que seulement 2,7% des ensembles de concurrents cités sont identiques d'un jour à l'autre. Ce chiffre seul devrait suffire à enterrer définitivement la pratique du test manuel ponctuel.
Pourquoi le test manuel vous induit en erreur
La pratique la plus courante dans les équipes marketing en 2026 reste la vérification manuelle : on ouvre ChatGPT, on pose la question, on note si la marque apparaît. Cette approche pose cinq problèmes structurels qui la rendent inutilisable comme système de suivi.
Premier problème : vous mesurez un point dans une distribution. Votre marque apparaît peut-être 40% du temps sur cette requête. Vous avez eu de la chance ou pas selon le moment où vous avez testé. Deuxième problème : vous ne couvrez qu'une plateforme. Vérifier dans ChatGPT uniquement vous fait manquer 89% des citations non-redondantes selon les analyses Omniscient. Votre concurrent que vous pensez battre sur ChatGPT est peut-être dominant sur Perplexity, Gemini ou Claude. Troisième problème : vous ne testez qu'un prompt. Les LLMs décomposent les requêtes complexes en dizaines de sous-requêtes via le query fan-out. Votre visibilité réelle est la somme de centaines de combinaisons de prompts, pas d'un seul test.
Quatrième problème : les résultats varient selon la formulation. La même intention exprimée différemment produit des réponses très différentes. "Meilleur outil GEO" et "logiciel pour mesurer sa visibilité IA" sont deux requêtes avec le même intent mais des espaces de réponse distincts. Cinquième problème : vous n'avez pas de baseline. Sans historique, impossible de savoir si vous progressez ou régressez. Une mesure sans référence temporelle n'est pas une mesure, c'est une anecdote.
La visibilité IA est une distribution, pas un score
C'est le changement de paradigme central que l'étude d'avril 2026 formalise. La visibilité IA ne se mesure pas comme un classement Google, où votre position est stable et vérifiable à tout moment. Elle se mesure comme une fréquence d'apparition sur un grand nombre de runs. La bonne question n'est pas « est-ce que j'apparais dans ChatGPT ? » mais « à quelle fréquence est-ce que j'apparais sur un ensemble représentatif de prompts, mesuré de façon répétée dans le temps ?
La méthode qui émerge comme standard dans l'industrie s'inspire des modèles de sondage électoral. Elle consiste à définir un échantillon représentatif de 250 à 500 prompts à fort intent dans votre catégorie, à les exécuter de façon automatisée sur plusieurs modèles, et à calculer un taux de mention moyen sur l'ensemble. Ce taux, calculé quotidiennement, donne une courbe de tendance fiable qui neutralise la variance individuelle de chaque prompt.
L'étude introduit également la notion de stabilité comme métrique complémentaire à la visibilité. Une marque peut avoir un taux de mention élevé mais très instable : elle apparaît souvent mais de façon imprévisible, selon les jours et les reformulations. Une autre peut avoir un taux plus bas mais très stable. Ces deux profils ont des implications stratégiques différentes. La marque instable a une autorité de citation fragile, susceptible de disparaître dès qu'un concurrent publie un contenu plus fort. La marque stable a construit une association solide dans les paramètres du modèle.
Ce que vos concurrents font pendant que vous testez manuellement
La conséquence pratique de ne pas mesurer correctement est que vous prenez des décisions stratégiques sur des données fausses. Vous êtes convaincu d'apparaître parce que vous avez vu votre marque une fois. Vous concluez qu'un concurrent est absent parce qu'il n'était pas dans le résultat que vous avez checké. Pendant ce temps, ce concurrent exécute 500 prompts automatiquement chaque jour, mesure son taux de mention à 37% sur ChatGPT et 52% sur Perplexity, et détecte qu'il progresse de 8 points en deux mois grâce à sa nouvelle série d'articles.
Le décalage entre les marques qui mesurent correctement et celles qui testent manuellement va s'accentuer. Les premières ont un système de feedback qui leur permet d'itérer rapidement : elles savent ce qui fonctionne, ce qui ne fonctionne pas, et elles ajustent. Les secondes naviguent à vue.
Les métriques GEO qui remplacement le "j'ai vérifié dans ChatGPT"
Un système de mesure GEO rigoureux repose sur quatre métriques principales. La première est le taux de mention : sur l'ensemble de vos prompts cibles, à quelle fréquence votre marque est-elle nommée ? C'est votre métrique de base, à suivre par plateforme et par catégorie de prompt. La deuxième est la part de voix IA : parmi toutes les marques citées sur vos prompts, quelle proportion vous est attribuée ? Cette métrique vous positionne par rapport à vos concurrents directs.
La troisième est la stabilité : votre taux de mention est-il constant sur 30 jours ou varie-t-il fortement ? Une forte variance signale une autorité de citation fragile. La quatrième est le sentiment : quand vous êtes cité, comment êtes-vous décrit ? Positif, neutre, ou avec des réserves ? Une marque citée fréquemment mais avec un sentiment ambigu peut perdre des deals en amont du clic.
Combien de prompts et de runs sont nécessaires pour une mesure fiable ?
La règle générale issue des pratiques 2026 : un minimum de 50 prompts bien construits couvre déjà les angles principaux d'une catégorie. Entre 250 et 500 prompts constitue l'échantillon représentatif recommandé pour une marque SaaS B2B avec plusieurs cas d'usage. En dessous de 30 prompts, les résultats ne sont pas statistiquement stables.
Sur la fréquence de mesure : quotidiennement est la cadence minimale pour détecter des variations significatives. Hebdomadairement, vous ratez les événements rapides comme le lancement d'un concurrent, une modification de politique d'OpenAI ou une mise à jour majeure d'un modèle qui peut faire varier votre visibilité de 15 points en 48 heures. Mensuellement, vous ne mesurez pas, vous constatez des dégâts après le fait.
Vizible AI mesure votre visibilité comme une distribution, pas comme un screenshot
C'est exactement ce que fait Vizible AI : la plateforme exécute automatiquement vos prompts cibles sur ChatGPT, Gemini, Perplexity, Claude, Mistral, DeepSeek et Groq chaque jour. Elle calcule votre taux de mention sur l'ensemble de vos prompts, suit votre part de voix par rapport à vos concurrents, mesure la stabilité de vos citations dans le temps, et analyse le sentiment associé à chaque mention. Le résultat est une distribution, pas un score. Une tendance, pas une anecdote.
La différence avec vérifier manuellement est structurelle. Une vérification manuelle vous dit ce qui s'est passé une fois. Vizible AI vous dit ce qui se passe en moyenne, comment ça évolue, et ce que vos concurrents font pendant que vous ne regardez pas.
Questions fréquentes
Pourquoi ChatGPT donne-t-il des réponses différentes à la même question ?
Les LLMs génèrent du texte en sélectionnant des tokens selon des distributions de probabilité, pas de façon déterministe. Le paramètre de température contrôle le niveau de variation : plus il est élevé, plus les réponses divergent. Quand le modèle accède au web en temps réel, les sources récupérées varient également entre chaque requête, amplifiant la différence de résultat.
Combien de fois faut-il tester un prompt pour avoir un résultat fiable ?
Il n'existe pas de chiffre universel, mais les pratiques 2026 convergent vers un minimum de 30 à 50 runs par prompt pour établir un taux de mention stable. En pratique, la méthode plus scalable est d'élargir le nombre de prompts plutôt que de multiplier les runs sur un seul prompt. Un ensemble de 50 prompts exécutés quotidiennement donne une courbe de tendance beaucoup plus exploitable.
Est-ce que tous les LLMs varient autant ?
Non. La variance dépend des paramètres de température et d'accès au web de chaque modèle. Les modèles avec recherche en temps réel varient généralement plus que les modèles qui répondent uniquement depuis leur connaissance paramétrique. C'est l'une des raisons pour lesquelles surveiller plusieurs LLMs simultanément donne une image plus fiable que se concentrer sur un seul.
Puis-je améliorer la stabilité de mes citations IA ?
Oui. La stabilité augmente quand votre marque est présente de façon conséquente sur plusieurs sources indépendantes : votre site, LinkedIn, G2, des publications sectorielles. Plus les LLMs trouvent votre marque citée dans des sources variées sur vos sujets cibles, plus l'association devient robuste et moins sensible à la variance stochastique.
Quelle différence entre taux de mention et part de voix IA ?
Le taux de mention mesure la fréquence absolue à laquelle votre marque apparaît dans les réponses. La part de voix IA est relative : elle compare votre taux de mention à celui de vos concurrents sur les mêmes prompts. Une marque peut avoir un taux de mention de 45% qui semble bon en absolu, mais une part de voix de seulement 18% si ses concurrents dominent les réponses restantes.
Mesurez votre visibilité IA comme elle devrait l'être
Un test manuel dans ChatGPT est une anecdote. Vizible AI est un système de mesure. La plateforme exécute vos prompts chaque jour sur 7 LLMs, calcule votre taux de mention et votre part de voix en temps réel, et vous montre si vous progressez ou régressez pendant que vos concurrents font de même. Commencez votre essai gratuit de 14 jours sur Vizible AI, sans carte bancaire.